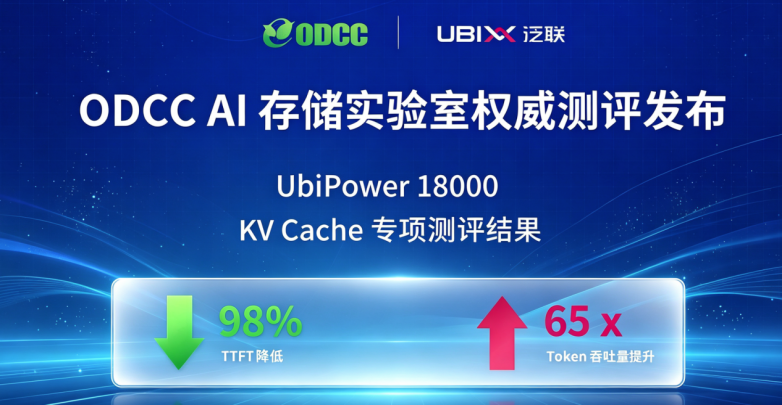
泛联通过ODCC KV Cache权威评测,助力大模型推理业务提效降本
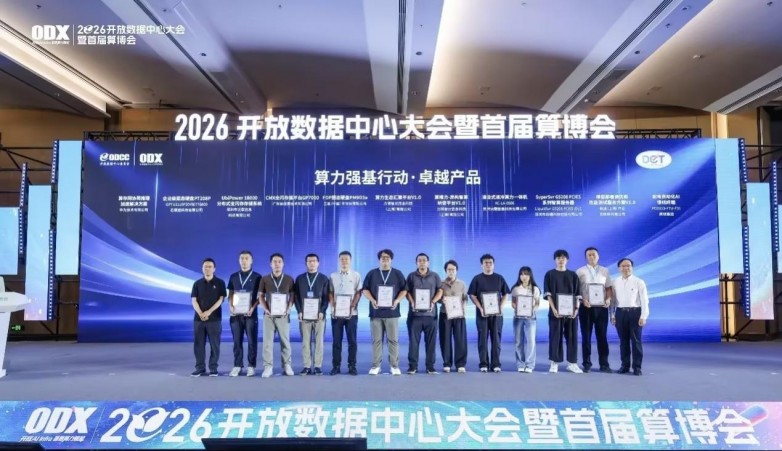
近日,2026 开放数据中心大会(ODX)如期举行。大会期间,开放数据中心委员会(ODCC)正式发布KV Cache推理存储专项测评结果,泛联UbiPower 18000 AI原生分布式全闪存储在多维度测试中表现突出,TTFT、TPS 多项核心性能指标刷新测试纪录,获得ODCC权威成果认证证书。
ODCC 是国内数据中心领域最具影响力的行业组织,其 AI 存储实验室评测体系覆盖架构设计、性能表现、生态兼容、工程落地等多个维度,测评标准严苛。本次KV Cache专项测评全真还原企业生产业务环境,以标准化手段验证产品实战能力,为行业技术迭代与商业化落地提供权威参考依据。UbiPower 18000 顺利通过全套严苛测试并获颁证书,代表该方案经过多场景生产级验证,得到产业官方认可,成为大模型推理存储领域优选方案。
Token爆发时代,KV Cache成为大模型推理提质降本关键
随着大模型技术快速普及,长上下文交互、高并发在线推理、复杂 Agent任务逐步成为业务主流,AI 产业全面进入大Token 高效处理时代。推理环节的响应速度、并发承载能力与落地成本,直接决定 AI 业务用户体验与商业化成效。KV Cache 作为大模型推理核心缓存技术,是提升推理效率、降低算力损耗的关键抓手。
当前行业传统存储普遍存在架构层级复杂、数据拷贝冗余等痛点,容易引发推理卡顿、首响应时延高、高并发下性能抖动等问题。同时高端 HBM GPU 采购成本高昂,中端GPU原生推理性能不足,也制约着大模型业务大规模落地。
UbiPower 18000 KV Cache 卸载极简架构,重构推理存储体系
针对大模型推理的核心瓶颈,UbiPower 18000 依托自研 GPU Direct RDMA零拷贝传输模块与精细化 RDMA 并发调度机制,实现全栈深度优化,彻底绕过宿主机 CPU 调度与传统文件系统元数据操作的繁重开销,实现 GPU 显存与分布式存储池之间 KV Cache 张量块的高速直连读取。该架构打破了GPU 物理显存容量限制,将 GPU 工作内存无缝外延至高性能外部存储池,在无需升级 GPU 硬件的前提下,显著提升显卡并发承载能力,从架构层面解决长上下文推理、高并发场景下的性能瓶颈。
依托上述核心技术,UbiPower 18000 实现了:
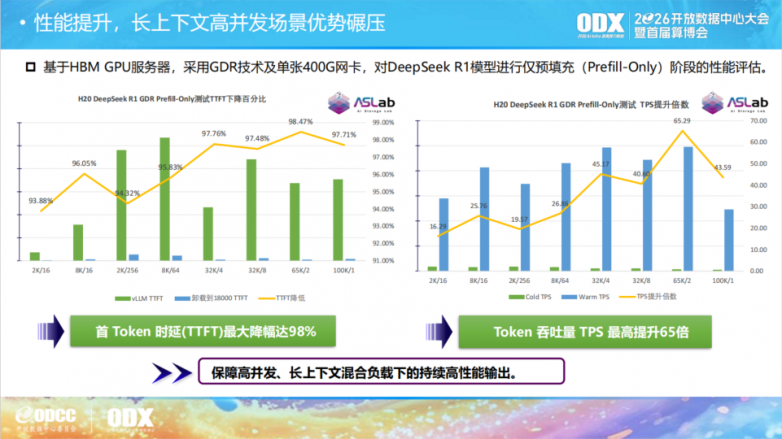
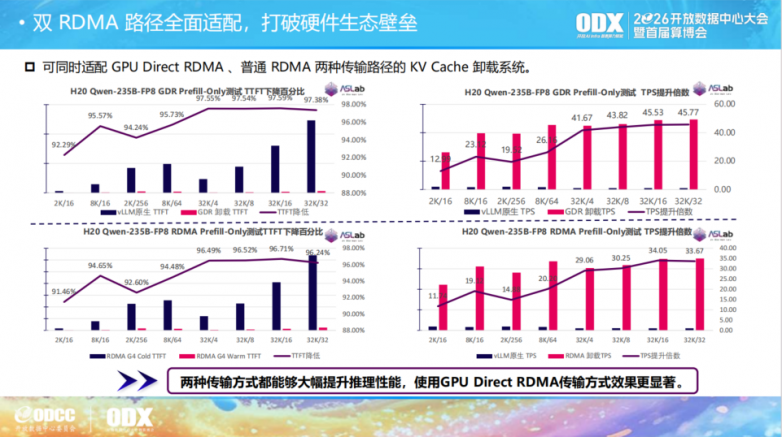
• 显著降低TTFT(Time To First Token,首 Token 时延),最大降幅98%,优化推理响应速度;
• 大幅提升系统TPS(Tokens Per Second,每秒生成 Token 数),最大提升65倍,压低单位Token 成本,提高 GPU 硬件投资回报率。
以上能力,在ODCC KV Cache测试中也得到了充分验证。
实测成果亮眼,实力获权威验证
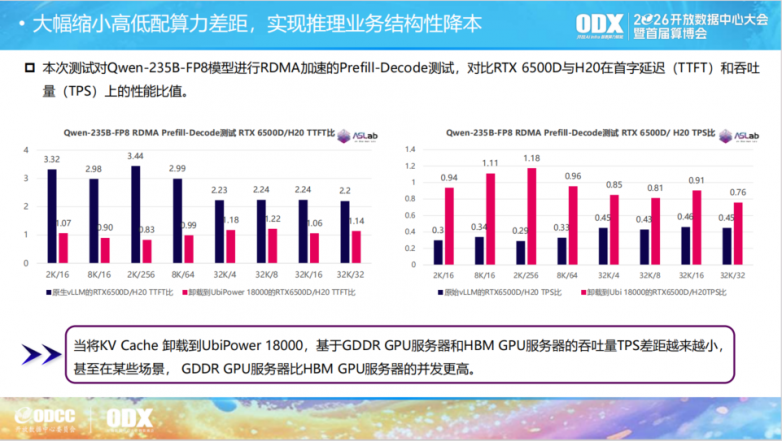
ODX 存储系统分论坛上,中国信通院工程师详细解读 AI 推理场景 KV Cache 存储方案测试结果,分享了 UbiPower 18000在多模型、多负载压力测试下,展现出突出的推理加速能力。总结UbiPower 18000在本次测试的三大成果:
• 性能量级跃升,长上下文高并发场景优势突出
• 双 RDMA 路径全面适配,打破硬件生态壁垒
• 大幅缩小高低配算力差距,实现推理业务结构性降本
给用户带来的直接收益为:
• 用户体验升级:首 Token 时延最高下降 98%,交互响应更快;吞吐量最高提升65倍,同等算力可承载更多推理并发用户。
• 硬件投资节约:抹平高低配算力性能差距,推理硬件采购成本可优化 3050%。GPU显存得到释放,硬件资源利用率显著提高,有效降低每 Token 推理单位成本。
• 业务运行可靠:规避显存溢出导致会话强制清空,保障 AI 智能体多轮业务连续稳定运行。
结语:此次顺利通过 ODCC KV Cache 严苛认证,标志着继大模型训练场景建立领先优势之后,泛联AI原生存储的推理场景技术实力获得权威印证。UbiPower 18000实现一机多模能力,为智算全链路构建坚实的数据底座。面向未来,泛联将持续深耕大模型推理核心赛道,持续优化 KV Cache 分层架构与全链路加速能力,以极简架构、极致性能、极优成本的完整解决方案,为 AI 产业规模化高质量发展筑牢存储根基。